


Hogyan működnek a webes keresőrobotok? Teljes technikai útmutató
Ismerje meg, hogyan működnek a webes keresőrobotok a kezdő URL-ektől az indexelésig. Értse meg a technikai folyamatokat, a keresőrobotok típusait, a robots.txt ...
8 perc olvasás
A keresőrobot egy automatizált program – más néven webrobot, pókbot vagy egyszerűen bot –, amely szisztematikusan böngészi a világhálót, hogy felfedezze, elolvassa és összegyűjtse a weboldalakról az információkat.
A Google bejáró robotjairól szóló dokumentáció ismerteti a Google által használt robot- és letöltő (fetcher) kategóriákat. Ezt a dokumentációt használd, amikor ellenőrzöd, hogyan fér hozzá egy adott Google-robot egy affiliate weboldalhoz.
Ezen az oldalon
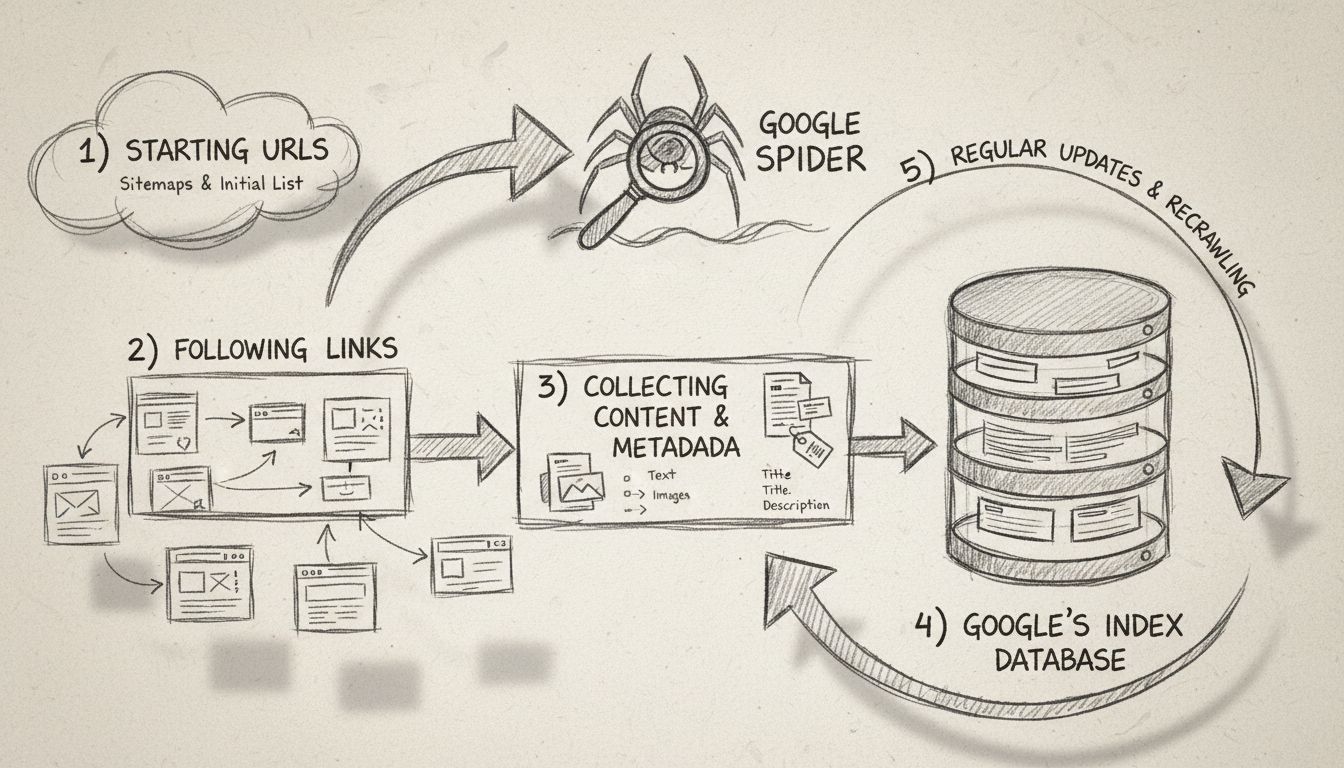
A keresőrobot egy automatizált program – más néven webrobot, pókbot vagy egyszerűen csak bot –, amely szisztematikusan böngészi a világhálót, hogy felfedezze, elolvassa és összegyűjtse a weboldalak tartalmát. A robot által összegyűjtött adatokat visszaküldi a keresőmotornak, amely azokat egy hatalmas, indexnek nevezett adatbázisba rendezi. Amikor valaki keresési lekérdezést indít, a motor ebből az indexből húzza elő a releváns találatokat, nem az élő webről.
A „spider" elnevezés onnan ered, ahogyan ezek a programok navigálnak a weben: hiperhivatkozásokat követnek oldalról oldalra, ahogyan a pók mozog a hálója szálain. A legkorábbi ismert bejáró robot, a WebCrawler, 1994-ben indult, és nagyban hozzájárult a máig is használt hasonlat elterjedéséhez.
A keresőrobot egy automatizált program – más néven webrobot, pókbot vagy egyszerűen csak bot –, amely szisztematikusan böngészi a világhálót, hogy felfedezze, elolvassa és összegyűjtse a weboldalak tartalmát. A robot által összegyűjtött adatokat visszaküldi a keresőmotornak, amely azokat egy hatalmas, indexnek nevezett adatbázisba rendezi. Amikor valaki keresési lekérdezést indít, a motor ebből az indexből húzza elő a releváns találatokat, nem az élő webről.
A „spider" elnevezés onnan ered, ahogyan ezek a programok navigálnak a weben: hiperhivatkozásokat követnek oldalról oldalra, ahogyan a pók mozog a hálója szálain. A legkorábbi ismert bejáró robot, a WebCrawler, 1994-ben indult, és nagyban hozzájárult a máig is használt hasonlat elterjedéséhez.
A Google a Googlebotot, a Bing a Bingbotot használja, és mindkettő olyan robot, amely ugyanazt az alapfeladatot látja el.

Állítsd be a fejlett nyomkövetést percek alatt. Bankkártya nem szükséges.
A feltérképezési folyamat megértése segít a webhelytulajdonosoknak jobb döntéseket hozni az oldalfelépítés, az oldalak fontossági sorrendje és a technikai SEO terén.
Minden robot ismert webcímek listájával indul, amelyeket kiindulási URL-eknek (seed URL) nevezünk. Ezek származhatnak korábban feltérképezett oldalakból, beküldött XML oldaltérképekből vagy korábbi feltérképezések során felfedezett linkekből. Minden kiindulási pontról a robot letölti az oldalt, és kinyeri az összes benne található hiperhivatkozást. Ezek a linkek egy sort – más néven feltérképezési frontvonalat – alkotnak a következőként meglátogatandó oldalak számára.
Amikor egy robot elér egy oldalt, három dolgot tesz:
User-Agent fejlécsztringgel azonosítja magát (pl. Googlebot/2.1).A folyamat folyamatos ciklusban fut:
A robot emellett a feltérképezés előtt minden domainen ellenőrzi a robots.txt fájlt is. Ha a fájl letilt egy elérési utat, egy jól nevelt robot kihagyja azt. A robotok betartják továbbá a meta robots címkéket és az X-Robots-Tag HTTP fejléceket is, amelyek arra utasítják őket, hogy ne indexeljenek egy oldalt, vagy ne kövessék a linkjeit.
Minden nagyobb keresőmotor a saját robotját üzemelteti. Íme azok, amelyek legnagyobb valószínűséggel felkeresik az oldaladat:
| A robot neve | Keresőmotor | User-Agent azonosító |
|---|---|---|
| Googlebot | Googlebot | |
| Bingbot | Bing | Bingbot |
| Slurp Bot | Yahoo (a Bing alapjaira épülve) | Slurp |
| DuckDuckBot | DuckDuckGo | DuckDuckBot |
| Baiduspider | Baidu (Kína) | Baiduspider |
| Yandex Bot | Yandex (Oroszország) | YandexBot |
| Applebot | Apple (Siri, Spotlight) | Applebot |
A Googlebot két változatban létezik: egy asztali robot, amely egy asztali böngészőt szimulál, és egy mobil robot, amely egy okostelefont. Mióta a Google áttért a mobil-first indexelésre, a mobil Googlebot a webhelyek túlnyomó többségének elsődleges feltérképezője.
A Bingbot a Bing indexét működteti, és a Yahoonak és más szindikációs partnereknek is szolgáltat találatokat. A DuckDuckBot a DuckDuckGo számára járja be a webet, amely saját indexét a Bing találataival egészíti ki. A Baiduspider és a Yandex Bot a kínai, illetve az orosz piacot szolgálja ki, és érdemes beengedni őket, ha van közönséged ezekben a régiókban.
Értesülj elsőként az új funkciókról és termékfrissítésekről.
A keresőrobotok mindezt látják, amikor meglátogatnak egy oldalt:
A robotok nem „látják" az oldalakat úgy, ahogyan az ember. Az alt szöveg nélküli képekbe ágyazott tartalom, a sikertelenül lefutó komplex JavaScriptben megjelenített szöveg, valamint a bejelentkezési falak vagy fizetőfalak mögötti tartalom a legtöbb robot számára láthatatlan. Az interaktív elemek – például űrlapok, legördülő menük és a felhasználói kattintást igénylő végtelen görgetésű tartalmak – szintén kimaradhatnak, hacsak az oldal nem használ megfelelő szerveroldali vagy dinamikus megjelenítést.
A crawl budget (feltérképezési keret) azoknak az oldalaknak a száma, amelyeket egy keresőrobot egy adott időszakon belül feltérképez az oldaladon. A Google két tényező alapján határozza meg a crawl budgetet:
Nagy webhelyeknél – e-kereskedelmi katalógusoknál, hírportáloknál vagy több ezer termékoldallal rendelkező affiliate oldalaknál – a crawl budget számít. Ha a robotok alacsony értékű URL-eken (szűrőparaméterek, munkamenet-azonosítók, ismétlődő oldalak) töltenek időt, előfordulhat, hogy a feltérképezési időablak lezárulta előtt nem jutnak el a fontos tartalmadhoz.
Három fő eszközöd van a robotok viselkedésének irányítására.
A domain gyökerében elhelyezett robots.txt fájl megmondja a robotoknak, hogy az oldalad mely részeit látogathatják, és melyeket nem. Egyszerű szintaxist használ:
User-agent: *
Disallow: /admin/
Disallow: /search/
/admin/ és a /search/ alatti elérési utak feltérképezésétől. Konkrét robotokat a user-agent azonosítójukkal célozhatsz meg:User-agent: Googlebot
Disallow: /private/
Oldalszintű szabályozáshoz használd a meta robots címkét a HTML <head> részében:
<meta name="robots" content="noindex, nofollow">
X-Robots-Tag) is elküldhetők, ami a nem HTML fájloknál, például PDF-eknél hasznos.Az XML oldaltérkép felsorolja azokat az URL-eket, amelyeket a robotoknak prioritásként kell kezelniük. Küldd be a Google Search Console vagy a Bing Webmaster Tools felületén. Az oldaltérkép nem garantálja a feltérképezést, de segít a robotoknak gyorsabban felfedezni az új és frissített oldalakat — különösen a mély felépítésű vagy korlátozott belső linkelésű webhelyeken.
A kifejezéseket gyakran összekeverik, pedig különböző célokat írnak le:
| Szempont | Webrobot (keresőrobot) | Webes kaparó |
|---|---|---|
| Cél | Oldalak felfedezése és indexelése a kereséshez | Meghatározott adatok kinyerése az oldalakról |
| Üzemeltető | Keresőmotorok (Google, Bing) | Magánszemélyek, vállalatok, kutatók |
| Hatókör | Széles körű — a teljes elérhető web | Célzott — konkrét oldalak vagy adatpontok |
| Eredmény | Kereshető index | Strukturált adatok (CSV, adatbázis, API) |
| Tiszteletben tartja a robots.txt-t | Igen (a legitim robotok) | Változó; sok kaparó figyelmen kívül hagyja |
A robot térképet készít; a kaparó a területet bányássza. Mindkettő automatizált, de alapvetően különböző célokat szolgálnak. Egyes eszközök, mint például a Screaming Frog SEO Spider, elmossák a határt — úgy járják be a webet, mint egy robot, de webhelyauditálásra használják őket, nem keresési indexelésre.
Nem önmagukban. A legitim keresőrobotok hasznosak — nélkülük az oldalad nem jelenne meg a keresési találatok között. De nem minden bot barátságos.
A káros bottevékenység jelei:
Az OpenAI GPTBot egy webes bejáró robot, amelyet MI-modellek képzési adatainak gyűjtésére használnak. Nem keresőmotoros robot — nem működtet nyilvános keresési indexet.
User-agent: GPTBot
Disallow: /
Ha aggódsz az adatvédelem miatt: a DuckDuckGo és a Brave Search az a két nagy keresőmotor, amely nem követi nyomon a felhasználókat, és nem épít személyes profilokat. Mindkettő saját robotot üzemeltet (a DuckDuckBot és a Brave robotja), és indexeiket más források találataival egészítik ki. A találatok rangsorolásához kontextuális kulcsszavakra támaszkodnak a felhasználói előzmények helyett, ami azt jelenti, hogy az oldalad on-page SEO-ja még fontosabb a láthatóság szempontjából ezeken a platformokon.
A keresőrobotok közvetlenül hatnak az affiliate marketing ökoszisztéma minden szereplőjére.
Az affiliate programod céloldalainak, feltételeket ismertető oldalainak és promóciós tartalmainak feltérképezhetőnek és indexelhetőnek kell lenniük. Ha a robotok nem érik el a programinformációidat, a potenciális affiliate partnerek, akik a „[a márkád] affiliate program" kifejezésre keresnek, lehet, hogy nem találnak rád organikusan. Kulcsfontosságú lépések:
Minden termékértékelés, összehasonlító cikk és útmutató, amelyet közzéteszel, attól függ, hogy megtalálják-e a keresésben — ez pedig feltérképezettséget és indexeltséget jelent. A robotok a kapuőrök. A bevált gyakorlatok:
lastmod dátumának módosítása arra ösztönözheti a robotokat, hogy hamarabb újra meglátogassák az oldalaidat.A robotok viselkedésének megértése segít jobban támogatni az affiliate partnereidet:
site: keresést), és hogy nem blokkolják-e véletlenül a robotokat.Fedezd fel, hogy a webes robotok megértése hogyan segít optimalizálni az oldaladat a jobb keresési helyezések érdekében, és hogyan növeli az affiliate bevételeidet.
Ismerje meg, hogyan működnek a webes keresőrobotok a kezdő URL-ektől az indexelésig. Értse meg a technikai folyamatokat, a keresőrobotok típusait, a robots.txt ...
Ismerje meg, hogyan fedezik fel és indexelik a keresőmotor-bejárók a weboldalakat, és hogy ez miért fontos a keresőoptimalizálás (SEO) szempontjából.
Tudja meg, mi az a Google Spider (Googlebot), hogyan térképezi fel és indexeli a weboldalakat, és miért nélkülözhetetlen a SEO szempontjából. Ismerje meg, hogya...
Csatlakozzon elégedett ügyfeleink közösségéhez és nyújtson kiváló ügyfélszolgálatot a Post Affiliate Pro-val.


Sütik Hozzájárulás
A sütiket használjuk, hogy javítsuk a böngészési élményt és elemezzük a forgalmunkat. See our privacy policy.