

Keresőrobot
A keresőrobot egy automatizált bot, amely weboldalakat jár be, hogy tartalmat indexeljen az olyan keresőmotorok számára, mint a Google és a Bing. Ismerd meg, ho...
10 perc olvasás
SEO
DigitalMarketing
+3
+++ term = “Mi az a keresőmotor-bejáró?” lastmod = “2026-10-08” title = “Mi az a keresőmotor-bejáró?” keywords = [ “keresőmotoros rangsorolás”, “keresőmotor”, “rangsorolás”, “keresőoptimalizálás”, “szerep a keresésben”, “bejárók”, “keresés”, “motor” ] url = “/affiliate-marketing-szojegyzek/crawlers/” aliases = [ “/affiliate-marketing-glossary/crawlers/” ] description = “Ismerje meg, hogyan fedezik fel és indexelik a keresőmotor-bejárók a weboldalakat, és hogy ez miért fontos a keresőoptimalizálás (SEO) szempontjából.” date = “2024-11-07 11:14:13” image = "" shortDescription = “A keresőmotor-bejáró automatizált szoftverprogram – más néven bot, pók (spider) vagy spiderbot –, amely szisztematikusan böngészi a World Wide Webet, letölti az oldalak tartalmát, és hiperhivatkozásokat követve új vagy frissített URL-eket fedez fel.” tags = [ “SEO”, “Crawlers”, “Indexing”, “AffiliateMarketing”, “SearchEngines”, “TechnicalSEO” ] categories = [ “Glossary” ] showCTA = true ctaHeading = “Optimalizálja webhelyét a keresőmotorok számára” ctaDescription = “Ismerje meg, hogyan növelheti webhelye láthatóságát és keresőmotoros rangsorolását, ha megérti a bejárókat, és optimalizál rájuk.” ctaPrimaryText = “SEO-tippek kérése” ctaPrimaryURL = “/blog/” ctaSecondaryText = “Próbálja ki a Post Affiliate Pro programot” ctaSecondaryURL = “/trial/”
[[faq]] question = “Tudna példát mondani egy webes bejáróra?” answer = “A Googlebot a legismertebb példa. Ez a Google elsődleges webes bejárója, amely milliárdnyi weboldal felfedezéséért és indexeléséért felel. További példák a Bingbot (Microsoft Bing), a DuckDuckBot (DuckDuckGo), a YandexBot (Yandex) és a Baiduspider (Baidu). Az MI oldalán az OpenAI GPTBotja és az Anthropic Claude-Webje olyan bejárók, amelyek nyilvánosan hozzáférhető adatokat gyűjtenek a modellek betanításához.”
[[faq]] question = “Mi az a bejárási keret (crawl budget), és miért fontos?” answer = “A bejárási keret azoknak az oldalaknak a száma, amelyeket egy keresőmotor egy adott időszakon belül bejár egy webhelyen. A bejárási sebességkorlát (milyen gyorsan tud a motor letölteni anélkül, hogy rontaná a teljesítményt) és a bejárási igény (mennyire akarja a motor bejárni az oldalakat a népszerűség és a frissesség alapján) határozza meg. A több ezer oldalas nagy webhelyeknek gondosan kell gazdálkodniuk a bejárási kerettel – ha az duplikált tartalomra, szemezgetős navigációs URL-ekre vagy hibás oldalakra pazarolódik, előfordulhat, hogy a nagy értékű oldalakhoz a bejáró soha nem jut el.”
[[faq]] question = “Hogyan ellenőrizhetem, hogy a webhelyemet bejárta-e a bejáró?” answer = “A legmegbízhatóbb módszerek:
[[faq]] question = “Letilthatok egy bejárót anélkül, hogy ez hatással lenne a SEO-mra?” answer = “Igen. Használjon adott user agentekre célzott robots.txt-utasításokat. Például a GPTBot letiltása nincs hatással a Googlebotra, a Bingbotra vagy bármely más keresőbejáróra. A kulcs a pontosság – használja a User-agent: GPTBot sort (nem a User-agent: sort), ha egyetlen bejárót szeretne letiltani úgy, hogy a keresőmotorok hozzáférése sértetlen maradjon. A robots.txt-módosításokat mindig tesztelje a Google Search Console-ban, mielőtt élesben bevezetné őket.”
[[faq]] question = “Hogyan használják a bejárókat az olyan MI-cégek, mint az OpenAI?” answer = “Az MI-cégek olyan bejárókat helyeznek üzembe, mint a GPTBot, hogy nyilvánosan hozzáférhető webes adatokat gyűjtsenek nagy nyelvi modellek betanításához, és lehetővé tegyék az élő információlekérést. Ezek a bejárók ugyanazokat az alapmechanizmusokat követik, mint a keresőmotor-bejárók – oldalakat töltenek le, hivatkozásokat követnek, és tiszteletben tartják a robots.txt-et –, de céljuk a modellbetanítás, nem pedig a keresési indexelés.”
[[lnks]] text = “mobil-first indexelés” path = “/blog/mobile-friendliness-affiliate-marketing/” title = “Miért valódi rangsorolási és bevételi tényező a mobilbarátság az affiliate marketingben – a Core Web Vitals mutatóktól a reszponzív designig –, és hogyan tesztelheti és javíthatja affiliate webhelyét mobilon.”
[[lnks]] text = “weboldal-bejárók” path = “/faq/why-are-web-crawlers-called-spiders/” title = “Ismerje meg, miért nevezik a webes bejárókat pókoknak (spider), hogyan működnek, és mi a kritikus szerepük a keresőmotoros indexelésben. Fedezze fel a webes bejárás mögött húzódó technikai mechanizmusokat 2025-ben.”
[[lnks]] text = “keret mindegyikhez” path = “/blog/optimize-affiliate-marketing-budget/” title = “hat gyakorlati stratégia az affiliate marketingkeret optimalizálásához, beleértve a közösségi média kihasználását és a réspiaci influenszerekkel való együttműködést”
[[lnks]] text = “Friss és releváns tartalom” path = “/faq/keep-content-fresh-engaging/” title = “Fedezze fel a hatékony stratégiákat, amelyekkel tartalma friss és lebilincselő marad. Ismerje meg a tartalomformátumokat, az elemzéseket, a közönség bevonását és a professzionális írástechnikákat, hogy fenntartsa a közönség érdeklődését és affiliate marketing sikereket érjen el.”
[[lnks]] text = “affiliate marketingesek” path = “/faq/what-makes-affiliate-marketing-content-rank-well/” title = “Fedezze fel azokat az alapvető tényezőket, amelyek miatt az affiliate marketing tartalom jól rangsorol a keresőmotorokban. Ismerjen meg bevált SEO-stratégiákat, tartalomoptimalizálási technikákat és bevált gyakorlatokat, amelyekkel növelheti affiliate webhelye láthatóságát és konverzióit.”
[[lnks]] text = “Kulcsszó-optimalizálás” path = “/faq/how-to-do-on-page-seo/” title = “Tanulja meg, hogyan optimalizálhatja az on-page SEO-t címetikettekkel, meta leírásokkal, fejlécekkel, kulcsszavakkal és tartalmi stratégiákkal. Sajátítsa el a technikai on-page optimalizálást, hogy javítsa keresési rangsorolását a PostAffiliatePro átfogó útmutatójával.”
[[lnks]] text = “Affiliate marketingesek” path = “/blog/top-keyword-research-tools-for-affiliate-marketers/” title = “Milyen kulcsszókutatási eszközöket használjanak az affiliate marketingesek, hogy tartalmuk magasabban rangsoroljon a Google-ben? Olvassa el ezt a cikket, és megtudja!”
[[lnks]] text = “Az affiliate hivatkozások jellemzően” path = “/affiliate-marketing-glossary/seo-affiliates/” title = “Az SEO-affiliates, más néven kereső-affiliates partnerek segítenek javítani webhelye rangsorolását a keresési találatok oldalán. Fedezze fel, hogyan használják az SEO-affiliates partnerek a szakértői stratégiákat a szerves forgalom növelésére és az affiliate marketing siker fokozására.”
[[lnks]] text = “Webes bejárók” path = “/faq/how-do-web-crawlers-work/” title = “Ismerje meg, hogyan működnek a webes bejárók a kiinduló URL-ektől az indexelésig. Értse meg a technikai folyamatot, a bejárótípusokat, a robots.txt-szabályokat, és azt, hogy a bejárók milyen hatással vannak a SEO-ra és az affiliate marketingre.”
[[lnks]] text = “SEO-ra gyakorolt hatás” path = “/faq/why-are-sitemaps-important/” title = “Ismerje meg, miért kulcsfontosságúak az oldaltérképek a SEO-siker szempontjából. Fedezze fel, hogyan javítják az XML- és HTML-oldaltérképek webhelye bejárhatóságát, indexelését és keresőmotoros láthatóságát.”
[[lnks]] text = “keresőmotorok” path = “/faq/how-to-identify-search-engine-crawlers/” title = “Ismerje meg, hogyan azonosíthatók a keresőmotor-bejárók user-agent azonosítók, IP-címek, kérésminták és viselkedéselemzés segítségével. Elengedhetetlen útmutató webmesterek és fejlesztők számára.”
[[lnks]] text = “kritikus a keresés szempontjából” path = “/faq/what-is-google-spider/” title = “Ismerje meg, mi az a Google Spider (Googlebot), hogyan járja be és indexeli a webhelyeket, és miért elengedhetetlen a SEO szempontjából. Fedezze fel, hogyan optimalizálhatja webhelyét a jobb bejárás érdekében.” +++ A keresőmotor-bejáró automatizált szoftverprogram – más néven bot, pók (spider) vagy spiderbot –, amely szisztematikusan böngészi a World Wide Webet, letölti az oldalak tartalmát, és hiperhivatkozásokat követve új vagy frissített URL-eket fedez fel. Elsődleges feladata, hogy friss adatokkal táplálja a keresőmotor indexét, így amikor valaki beír egy keresőkifejezést, a motor releváns, naprakész találatokat tudjon visszaadni. Bejárók nélkül a keresőmotor nem is tudná, hogy egy oldal egyáltalán létezik.
A bejáró maga nem rangsorol semmit. Felfedezi az oldalakat, és amit talál – szöveget, hivatkozásokat, metaadatokat, képeket –, azt átadja egy külön indexelő és rangsoroló rendszernek. A bejárás, az indexelés és a rangsorolás három különálló szakasz. Egy oldalt bejárhat a bejáró, mégsem jelenik meg soha a keresési találatok között, ha az indexelés során nem felel meg a keresőmotor minőségi követelményeinek.
A Google bejárókkal foglalkozó dokumentációja megkülönbözteti az általános bejárókat, a speciális esetekre szolgáló bejárókat és a felhasználói kérésre működő lekérőket. Ha hozzáférési problémákat vizsgál, ellenőrizze az adott bejáró dokumentált azonosítóját és viselkedését.
Ezen az oldalon
A webes bejáró néhány alapvető lépésből álló, folyamatosan ismétlődő körforgásban működik. Ha a webhelytulajdonosok megértik ezeket a lépéseket, könnyebben kideríthetik, miért nem jelennek meg az oldalaik a keresési találatok között – a probléma ugyanis gyakran már a bejárási szakaszban felmerül, jóval azelőtt, hogy a rangsorolás szóba kerülne.
Minden bejáró ismert URL-ek egy halmazával, az úgynevezett kiinduló URL-ekkel (seed URL) kezdi a munkát. Ezek származhatnak korábban már bejárt oldalakról, beküldött oldaltérképekből vagy kézzel kiválasztott kiindulási pontokból. A bejáró letölti az egyes kiinduló oldalakat, kinyeri az összes hiperhivatkozást, és minden még nem látott hivatkozást hozzáad a bejárási határvidéknek (crawl frontier) nevezett futó sorhoz.
A ciklus ezután megismétlődik:
Ez a körforgás valójában soha nem ér véget. A web folyamatosan változik, és minden másodpercben új oldalak jelennek meg, ezért a bejáró egyszerűen végigdolgozza a sorban következő URL-eket, időnként visszatér a régi oldalakhoz, hogy ellenőrizze a változásokat, és hozzáadja az újonnan felfedezett URL-eket.
Amint a bejáró letölt egy oldalt, megjeleníti a tartalmat – beolvassa a HTML-t, ahol lehetséges, lefuttatja a JavaScriptet, és kinyeri a szöveget, a képeket, a metaadatokat és a strukturált adatokat. Ezután letölti ezeket az információkat, és továbbítja a keresőmotor indexelőjének.
Nem minden bejáró bánik egyformán jól a JavaScripttel. A Googlebot megjeleníti a JavaScriptet, és megvárja a dinamikusan betöltött tartalmat, a kisebb keresőmotor-bejárók azonban gyakran csak a statikus HTML-t olvassák. Éppen ezért a kizárólag kliensoldali JavaScript-keretrendszerekkel épített oldalak láthatatlanok maradhatnak egyes keresőmotorok számára, hacsak nincs szerveroldali megjelenítés.
A bejárók két fő csatornán keresztül fedeznek fel új oldalakat:

Állítsd be a fejlett nyomkövetést percek alatt. Bankkártya nem szükséges.
A bejárók nem bánnak egyformán minden oldallal. Úgynevezett bejárási szabályzatok szerint működnek, amelyek meghatározzák, hogy mely oldalakat látogassák meg, milyen sorrendben és milyen gyakran térjenek vissza.
A bejárónak el kell döntenie, hogy a bejárási határvidéken lévő URL-ek közül melyeket részesítse előnyben. A leggyakoribb jelzések a következők:
Az, hogy milyen gyakran tér vissza a bejáró egy oldalra, attól függ, milyen ütemben változik az oldal. Egy hírportál főoldalát akár néhány percenként is bejárhatja. Egy statikus “Rólunk” (About Us) oldalra viszont akár havonta is csak egyszer tér vissza. A webmesterek az XML-oldaltérkép <changefreq> címkéivel jelezhetik a változás gyakoriságát, bár a keresőmotorok ezeket inkább javaslatként, semmint utasításként kezelik.
A bejárókat úgy programozzák, hogy ne terheljék túl a webkiszolgálókat. Tiszteletben tartanak egy bejárási sebességkorlátot (crawl rate limit) – vagyis azt a maximális kérésszámot, amelyet egy adott időszakban egyetlen webhelyre küldenek. Ha a szerver 500-as vagy 503-as HTTP-hibával válaszol, a bejáró visszavonul, hogy ne tetézze a bajt. Ez is hozzájárul ahhoz, hogy a nagy léptékű bejárás igazi mérnöki kihívás legyen.
A robots.txt fájl egy egyszerű szöveges dokumentum, amelyet a domain gyökerében helyeznek el, és amely megmondja a bejáróknak, hogy mely URL-eket kérhetik le és melyeket nem. Ez a legfontosabb eszköz a bejárók hozzáférésének szabályozására. Egy robots.txt-bejegyzés például így nézhet ki:
User-agent: Googlebot
Disallow: /private/
Allow: /public/
/private/ alatt található, de engedélyezi mindazt, ami a /public/ alatt van. Más bejárók is ellenőrzik ezt a fájlt, és a saját User-agent utasításaikat követik. Érdemes megjegyezni, hogy a robots.txt önkéntes alapon működő protokoll – a jól nevelt bejárók betartják, a rosszindulatú botok azonban teljesen figyelmen kívül hagyhatják.A bejárási keret (crawl budget) azoknak az oldalaknak a száma, amelyeket egy keresőmotor adott időszakon belül bejár egy webhelyen. Két tényező határozza meg:
Kis webhelyeknél a bejárási keret ritkán okoz gondot. A több millió URL-lel rendelkező nagy e-kereskedelmi platformok vagy tartalmi webhelyek esetében viszont elengedhetetlen a bejárási keret kezelése – a duplikált tartalmakra, szemezgetős navigációs paraméterekre vagy alacsony értékű oldalakra elpazarolt bejárások kevesebb erőforrást hagynak a tényleg fontos oldalaknak.
Minden jelentős keresőmotornak saját bejárója van, egyedi user-agent azonosítóval (user-agent string) – ez az azonosító, amelyet a bot minden HTTP-kéréssel elküld, hogy a szerverek tudják, melyik bejáró látogatja őket.
| Keresőmotor | Bejáró neve | User-Agent azonosító | Rendeltetés |
|---|---|---|---|
| Googlebot | Googlebot/2.1 | Weboldalakat jár be és indexel a Google Kereső és más Google-szolgáltatások számára | |
| Bing | Bingbot | Mozilla/5.0 (compatible; bingbot/2.0) | Oldalakat jár be és indexel a Microsoft Bing számára |
| DuckDuckGo | DuckDuckBot | DuckDuckBot/1.0 | Oldalakat jár be a DuckDuckGo keresési találataihoz |
| Yandex | YandexBot | Mozilla/5.0 (compatible; YandexBot/3.0) | Oldalakat jár be a Yandex kereső számára (Oroszországban meghatározó) |
| Baidu | Baiduspider | Mozilla/5.0 (compatible; Baiduspider/2.0) | Oldalakat jár be a Baidu kereső számára (Kínában meghatározó) |
| Apple | Applebot | Applebot/1.0 | Oldalakat jár be a Spotlight keresés és a Siri-javaslatok számára |
A Google emellett speciális bejárókat is üzemeltet az egyes tartalomtípusokhoz – a Googlebot Image képeket jár be, a Googlebot Video a videótartalmakkal foglalkozik, a Googlebot News a hírcikkekre összpontosít, az AdsBot pedig a Google Ads hirdetéseinek céloldal-minőségét ellenőrzi.
Értesülj elsőként az új funkciókról és termékfrissítésekről.
Annak megállapításához, hogy egy látogató valóban a Googlebot-e, többre van szükség, mint a user-agent azonosító ellenőrzése, hiszen ezek az azonosítók hamisíthatók. Egy Google-bejáró ellenőrzéséhez a következőket tegye:
Googlebot keresőkifejezéssel.googlebot.com vagy google.com domainre kell mutatnia.A Google hivatalos dokumentációt vezet az IP-tartományairól a google.com/bot.html címen. Az a látogató, aki a Googlebotnak adja ki magát, de nem megy át ezeken az ellenőrzési lépéseken, hamisított bot, ezért gyanúsként kell kezelni.
Igen – de korlátozásokkal. A nagy keresőmotorok külön bejárókat üzemeltetnek a nem szöveges tartalmakhoz:
VideoObject séma, hogy megértse a címet, a leírást, az előnézeti képet és az időtartamot.A bejárók azonban nem “látják” a képeket úgy, ahogyan az ember, és nem is “nézik” meg a videókat. A relevancia megállapításához kizárólag szöveges jelzésekre támaszkodnak – fájlnevekre, alt attribútumokra, feliratokra, a környező törzsszövegre és a strukturált adatokra. A bejelentkezési falak mögött, fizetőfalak (paywall) mögött rejlő vagy bonyolult JavaScript-lejátszókba ágyazott tartalmakat előfordulhat, hogy a bejáró egyáltalán nem járja be.
Ezeket a kifejezéseket gyakran szinonimaként használják, pedig különböző dolgokról van szó:
| Szempont | Webbejáró | Webkaparó |
|---|---|---|
| Rendeltetés | URL-ek felfedezése és indexelése a teljes weben | Meghatározott adatok kinyerése célzott oldalakról |
| Hatókör | Széles – mindenhová követi a hivatkozásokat | Szűk – ismert URL-eket vagy domaineket céloz meg |
| Eredmény | Keresési indexet táplál | Strukturált adatokat állít elő (CSV, adatbázis, táblázatkezelő) |
| Jellemző üzemeltető | Keresőmotorok (Google, Bing) | Vállalkozások, kutatók, adatelemzők |
| Tiszteletben tartja a robots.txt-et | Igen (a jogszerű bejárók) | Változó – sok kaparó figyelmen kívül hagyja |
| Példák | Googlebot, Bingbot | Árfigyelő eszközök, leadgeneráló kaparók, mesterséges intelligenciát tanító adatgyűjtők |
A keresőmotorok több csatornán keresztül találnak új oldalakat:
A leggyorsabb út ahhoz, hogy egy új oldalt bejárjon a bejáró, ha közvetlenül a Search Console-on keresztül küldi be az URL-t, és gondoskodik arról, hogy az oldalra mutasson hivatkozás ugyanannak a webhelynek egy már indexelt oldaláról.
Nincs rögzített ütemterv. Az újralátogatás gyakorisága a következőktől függ:
A webhelytulajdonosok befolyásolhatják az újralátogatás gyakoriságát azzal, hogy rendszeresen publikálnak tartalmat, gyors szerverválaszidőt tartanak fenn, és frissített oldaltérképeket küldenek be. Végső soron azonban a bejáró dönt a saját ütemezéséről az általa észlelt jelzések alapján.
A bejárók általában nem férnek hozzá:
A bejáró csak azt látja, ami nyilvánosan hozzáférhető és hivatkozott. Ha egy oldal megjelenítéséhez hitelesítésre vagy felhasználói interakcióra van szükség, az oldal gyakorlatilag láthatatlan a keresőmotorok számára – hacsak a webhelytulajdonos kifejezetten hozzáférést nem ad, vagy alternatív utat nem biztosít, például az URL-t felsoroló oldaltérképet, amelyet a tartalmat leíró strukturált adatokkal egészít ki.
Bejárót építeni néhány száz oldalnyi működéshez egyszerű feladat. Olyat építeni, amely milliárdnyi oldallal megbirkózik, egészen más probléma. A gyakori meghibásodási pontok a következők:
A legtöbb vállalkozás számára nem praktikus nagyméretű webes bejárót üzemeltetni felügyelt infrastruktúra nélkül. A döntés általában arra egyszerűsödik, hogy meglévő eszközt használnak, nem pedig a nulláról építenek sajátot.
Az Egyesült Államokban a nyilvánosan hozzáférhető oldalak webes bejárása általában legális. Több bírósági döntés – köztük a *hiQ Labs v.
A jogszerűség azonban több tényezőtől függ:
Fontos a különbség a keresési indexelés céljából végzett bejárás (széles körben elfogadott) és a kereskedelmi adatkinyerés céljából végzett kaparás (jogilag vitatottabb) között. A legtöbb jogszerű keresőmotor-bejáró egyértelműen legális területen működik.
Nem – a ChatGPT önmagában nem webes bejáró. A ChatGPT egy beszélgetésre alkalmas MI-modell, amely válaszokat generál. Az OpenAI azonban üzemeltet egy különálló, GPTBot nevű webes bejárót, amely nyilvános weboldalakat jár be, hogy betanítási adatokat gyűjtsön az MI-modellek számára, és támogassa az élő adatlekérési funkciókat egyes OpenAI-termékekben.
A GPTBot a GPTBot user-agent azonosítóval mutatkozik be, és tiszteletben tartja a robots.txt utasításait. Azok a webhelytulajdonosok, akik kifejezetten a GPTBotot szeretnék letiltani, a következőt adhatják hozzá a robots.txt fájljukhoz:
User-agent: GPTBot
Disallow: /
A keresőmotor-bejárók közvetlenül érintik az affiliate marketing ökoszisztéma minden szereplőjét. Ha egy oldalt nem jár be a bejáró, nem is rangsorol, és ha nem rangsorol, nem hoz szerves forgalmat – és affiliate bevételt sem.
Egy kiadó tartalmi webhelyének sorsa a bejárhatóságon múlik. Minden termékismertetőnek, összehasonlító útmutatónak vagy ajánlatgyűjteménynek felderíthetőnek kell lennie a bejárók számára. A kiadók gyakori hibái, amelyek megakadályozzák a bejárást:
A kiadóknak ellenőrizniük kell, hogy legértékesebb oldalaik szerepelnek-e a Google Search Console indexlefedettségi jelentésében, és hogy semmilyen noindex címke vagy robots.txt-szabály ne blokkolja őket véletlenül.
Annak a hirdetőnek, aki affiliate programot működtet, szüksége van arra, hogy termékoldalait bejárják és indexeljék, hogy a kiadók élő, látható oldalakra hivatkozhassanak. Ha egy kereskedő termékoldalai nincsenek a Google indexében, a kiadóknak nincs hová irányítaniuk a forgalmat. A konkrét kockázatok közé tartozik:
A kereskedőknek tiszta URL-struktúrát kell fenntartaniuk, termék-oldaltérképeket kell beküldeniük, és figyelniük kell a Search Console bejárási statisztikáit, hogy még azelőtt észrevegyék a problémákat, mielőtt azok a kiadói partnereket is érintenék.
A programmenedzserek a kereskedők és a kiadók között helyezkednek el, ezért érdemes érteniük a bejárók viselkedését ahhoz, hogy elháríthassák a láthatósági problémákat. Amikor egy kiadó azt jelenti, hogy egy kereskedő termékoldala “nem jelenik meg a Google-ben”, a probléma gyakran bejárási vagy indexelési hiba – nem pedig rangsorolási. A gyakorlati lépések a következők:
site: keresőoperátorával, hogy az oldal indexelve van-e.Az a programmenedzser, aki képes diagnosztizálni az alapvető bejárási problémákat, közvetlen értéket teremt az affiliate kapcsolat mindkét oldalán – segít a kereskedőknek a technikai hibák kijavításában, és segít a kiadóknak meggyőződni arról, hogy az általuk népszerűsített oldalak megtalálhatók.
Kezelje több partner programját és javítsa partnerei teljesítményét a Post Affiliate Pro-val.
A keresőrobot egy automatizált bot, amely weboldalakat jár be, hogy tartalmat indexeljen az olyan keresőmotorok számára, mint a Google és a Bing. Ismerd meg, ho...

Ismerje meg, hogyan működnek a webes keresőrobotok a kezdő URL-ektől az indexelésig. Értse meg a technikai folyamatokat, a keresőrobotok típusait, a robots.txt ...
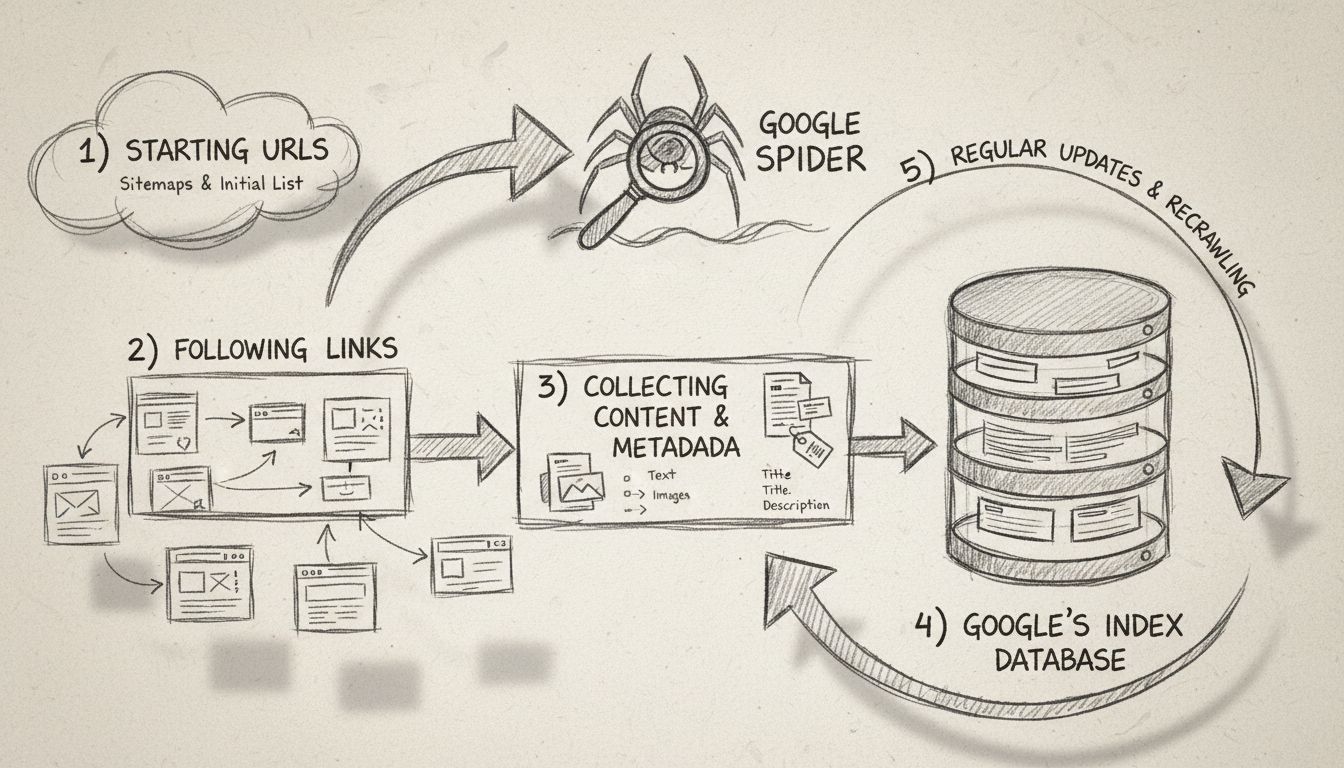
Tudja meg, mi az a Google Spider (Googlebot), hogyan térképezi fel és indexeli a weboldalakat, és miért nélkülözhetetlen a SEO szempontjából. Ismerje meg, hogya...
Csatlakozzon elégedett ügyfeleink közösségéhez és nyújtson kiváló ügyfélszolgálatot a Post Affiliate Pro-val.
Sütik Hozzájárulás
A sütiket használjuk, hogy javítsuk a böngészési élményt és elemezzük a forgalmunkat. See our privacy policy.